GCP 기반 GraphDB, 뭘 선택해야 할까? – Spanner Graph와 BigQuery Graph를 같은 데이터, 같은 GQL로 비교해 보기
안녕하세요. GS Neotek 김민형 입니다.
GCP에서 그래프 데이터베이스를 쓰려면 Spanner Graph와 BigQuery Graph 두 가지 선택지가 있습니다.
둘은 같은 CREATE PROPERTY GRAPH 문법과 ISO 표준 GQL을 쓰기 때문에 겉보기에는 거의 같지만, 저장 구조와 실행 엔진이 달라 잘하는 일이 정반대입니다.
이번 글에서는 두 서비스의 차이를 저장 구조와 실행 방식으로 설명하고, 같은 데이터와 같은 GQL로 실측한 결과를 바탕으로 어떤 상황에 무엇을 선택해야 하는지 정리합니다.
GraphRAG에 그래프 DB가 왜 필요한지도 의미 검색과의 비교로 함께 다룹니다.
한눈에 보기
| 항목 | 내용 |
| 비교 대상 | Spanner Graph(온라인, 실시간)와 BigQuery Graph(오프라인, 배치) |
| 공통점 | 1. ISO GQL과 SQL/PGQ 표준 질의 2. CREATE PROPERTY GRAPH로 기존 테이블을 그래프로 매핑(데이터 복제 없음) 3. 같은 시각화 인터페이스 |
| 차이점 | 1. 저장: 인터리브 스플릿과 컬럼 저장 2. 실행: 키 기반 조인과 스테이지 병렬 스캔 3. 과금: 노드 시간과 slot 시간 |
| 실측 환경 | 가상의 공급망 데이터, 노드 64,078개, 엣지 331,642개, 자연어 문서 64,009건(768차원 임베딩) |
| 결론 | 국소 탐색과 GraphRAG는 Spanner Graph, 전체 집계는 BigQuery Graph, 둘 다 필요하면 함께 사용 |
그래프 DB란 무엇이고 왜 필요한가
그래프 DB는 데이터를 노드(개체)와 엣지(관계)로 저장하고, 관계를 따라가는 질의를 기본 기능으로 제공하는 데이터베이스입니다.
Spanner Graph와 BigQuery Graph의 공통 기반인 속성 그래프(Property Graph) 모델은 노드와 엣지에 각각 레이블(종류)과 속성(키와 값)을 붙입니다.
예를 들어 고객사 노드가 제품 노드로 ORDERED 엣지를 가지고, 그 엣지에 주문 금액 속성이 붙는 식입니다.
RDF 트리플 저장소와 달리 엣지 자체에 속성을 바로 둘 수 있다는 점이 다릅니다.
관계형 DB에서도 관계는 외래 키와 조인으로 표현할 수 있습니다.
하지만 “이 공장의 사고로 영향받는 고객사는 누구인가”처럼 여러 단계를 건너는 질문은 단계마다 조인이 늘어나고, 몇 단계를 건너야 하는지 미리 알 수 없는 질문(지분 사슬, 다단계 BOM)은 SQL만으로 표현하기 어렵습니다.
그래프 DB는 (a)-[e]->(b) 형태의 패턴, {1,6} 같은 가변 길이 경로, ANY SHORTEST 같은 최단 경로를 질의 언어 자체에서 지원하므로 이런 질문을 한 문장으로 씁니다.
공급망 영향 분석, 숨은 지분 구조 추적, 사기 조직 탐지, 고객 360, 그리고 LLM에 연결된 근거를 넘기는 GraphRAG가 대표적인 용도입니다.
Spanner와 BigQuery는 어떤 서비스인가
Spanner는 수평으로 확장되는 분산 관계형 데이터베이스로, 강한 일관성과 높은 가용성 위에서 온라인 트랜잭션을 처리하는 데 맞춰져 있습니다.
BigQuery는 대규모 데이터를 컬럼 단위로 저장하고 slot이라는 병렬 처리 자원으로 분석 쿼리를 실행하는 분산 분석 엔진(데이터 웨어하우스)입니다.
두 서비스 모두 CREATE PROPERTY GRAPH로 기존 테이블 위에 그래프를 선언하는 방식이라, 어느 쪽을 쓰든 데이터는 원래 테이블에 그대로 있습니다.
| 항목 | Spanner | BigQuery |
| 성격 | 온라인 트랜잭션(OLTP), 실시간 | 분석, 배치 |
| 저장과 실행 | 행 기반, 스플릿 단위 분산, 키 기반 조인 | 컬럼 기반, slot 병렬 스캔과 셔플 |
| 확장 방식 | 노드 수에 비례해 QPS가 선형 확장 | 예약 slot 수만큼 병렬 처리 |
| 쿼리 지연 | 몇 밀리초에서 몇 초 | 몇 초에서 몇 시간 |
| 데이터 신선도 | 커밋 즉시 반영, 강한 일관성 | 쿼리 시점의 테이블 기준(근실시간 또는 배치) |
| 과금 | 노드 시간, 쿼리 수와 무관하게 상시 과금 | slot 시간, 쿼리가 돌 때만 과금 |
| 그래프 기능 | Spanner Graph, 2024년 12월 GA | BigQuery Graph, 2026년 8월 GA |
그래프 DB의 저장 방식과 질의 언어
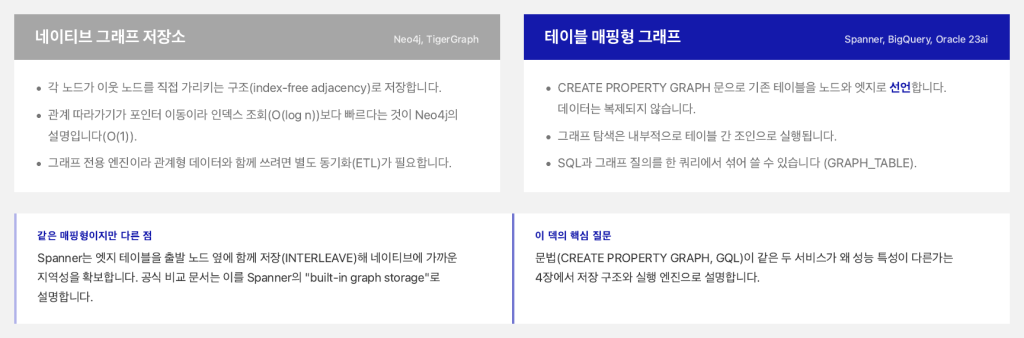
그래프 DB는 관계를 저장하는 방식에 따라 두 갈래로 나뉩니다.
Neo4j, TigerGraph 같은 네이티브 그래프 저장소는 각 노드가 이웃 노드를 직접 가리키는 구조(index-free adjacency)로 저장해 관계를 따라가는 일이 포인터 이동이 됩니다.
대신 그래프 전용 엔진이라 관계형 데이터와 함께 쓰려면 별도 동기화(ETL)가 필요합니다.
Spanner, BigQuery, Oracle 23ai 같은 테이블 매핑형 그래프는 CREATE PROPERTY GRAPH 문으로 기존 테이블을 노드와 엣지로 선언하고, 그래프 탐색을 내부적으로 테이블 간 조인으로 실행합니다.
같은 매핑형이지만 Spanner는 엣지 테이블을 출발 노드 옆에 함께 저장(INTERLEAVE)해 네이티브에 가까운 지역성을 확보하며, 공식 비교 문서는 이를 Spanner의 “built-in graph storage”로 설명합니다.
질의 언어는 두 서비스 모두 국제 표준 두 가지를 지원합니다.
| 언어 | 표준 | 특징 | Spanner, BigQuery |
| GQL | ISO/IEC 39075:2024 | 그래프 전용 표준 질의 언어. SQL 이후 첫 ISO 신규 DB 언어이며 NEXT로 쿼리를 이어 붙입니다 | 지원 |
| SQL/PGQ | ISO/IEC 9075-16:2023 | SQL의 FROM 절 안에서 GRAPH_TABLE로 그래프 패턴을 질의합니다 | 지원 |
| Cypher | Neo4j(openCypher) | GQL 설계에 큰 영향을 준 패턴 언어입니다 | 미지원. Spanner는 변환 가이드 제공 |
| Gremlin, SPARQL | Apache TinkerPop, W3C | 함수형 순회 언어와 RDF 트리플 질의 언어입니다 | 미지원 |
이름이 비슷한 GraphQL은 API 계층의 질의 언어라 그래프 DB를 탐색하는 GQL과는 계층이 다릅니다.
GraphQL API 서버의 리졸버가 내부에서 Spanner Graph에 GQL을 실행하는 구성처럼 함께 쓸 수 있습니다.
의미 검색만으로는 답하지 못하는 질문
그래프 DB가 GraphRAG에 왜 필요한지는 의미 검색의 한계에서 출발합니다.
의미 검색은 문서를 임베딩 벡터로 바꾼 뒤 질문 벡터와 가장 가까운 문서를 찾는 방식이라, 단어가 달라도 뜻이 비슷하면 찾아냅니다.
하지만 “비슷한 문서”를 찾을 뿐 문서 사이를 이어 붙이거나 전체를 세지는 못합니다.
| 질문 유형 | 예시 | 의미 검색이 실패하는 이유 |
| 다중 홉 | A 공장 사고로 영향받는 고객사는? | 2번째, 3번째 홉의 문서는 질문과 문장이 비슷하지 않아 검색 결과에 들어오지 않습니다 |
| 전역 질문 | 전체 공급망의 주요 위험 패턴은? | 답이 한 문서에 없고, top-k는 전체 코퍼스의 일부만 봅니다 |
| 집계, 계수 | 영향 주문 금액 합계는? | 검색은 k건을 돌려줄 뿐 전체를 세거나 더하지 못합니다 |
| 정확한 조건 | 품번 BC-6606과 BC-6656 | 임베딩은 유사도를 잴 뿐 값 일치, 범위, 조인 조건을 강제하지 못합니다 |
| 부정 | 다른 지역에 생산처가 없는 부품 | “있다”와 “없다”만 다른 문장은 거의 같은 벡터가 됩니다 |
GraphRAG는 이 한계를 역할 분담으로 풉니다.
벡터나 전문 검색으로 질문과 의미가 가까운 시작점(시드 노드)을 찾고, 시드에서 관계를 따라 N홉을 확장해 연결된 사실을 모은 뒤, GQL과 SQL로 조건을 걸고 세고 더한 결과를 LLM에 근거로 넘깁니다.
Spanner Graph는 벡터 검색과 그래프 확장을 한 쿼리에서 처리하므로 별도 벡터 DB 없이 이 패턴을 구현할 수 있습니다.
Spanner Graph: 실시간 트랜잭션 DB 위의 그래프
Spanner Graph는 Spanner의 확장성, 가용성, 강한 일관성 위에 그래프 기능을 더한 서비스입니다.
2024년 12월에 GA가 되었고, Enterprise와 Enterprise Plus 에디션에서 GoogleSQL 방언 DB에만 쓸 수 있습니다.
무료 체험판 인스턴스(90일, 10GB)에서도 Graph를 지원하지만, 공식 문서는 체험판이 성능 평가 용도가 아니라고 명시합니다.
그래프 정의보다 그 아래 테이블을 어떻게 배치하느냐가 성능을 좌우합니다.
공식 문서는 인터리브를 그래프 쿼리 성능에 결정적이라고 설명하며, 성능을 만드는 요소는 세 가지입니다.
- INTERLEAVE IN PARENT: 엣지 행을 출발 노드 행과 같은 스플릿에 함께 저장해 순방향 탐색을 로컬 읽기로 만듭니다.
- FOREIGN KEY: 엣지에서 도착 노드로 가는 길을 보장해 도착 테이블 스캔을 없애고 끊어진 엣지를 막습니다.
- 역방향 인덱스: 도착 키 보조 인덱스를 도착 노드 테이블에 인터리브해 거꾸로 따라가는 탐색도 빠르게 합니다.
-- 엣지: 하위 부품 -[COMPONENT_OF]-> 상위 부품 (출발 노드에 인터리브)
CREATE TABLE PartComponentOfPart (
  part_id STRING(16) NOT NULL,
  parent_part_id STRING(16) NOT NULL,
  quantity INT64,
  CONSTRAINT FK_ComponentParent FOREIGN KEY (parent_part_id) REFERENCES Part (part_id),
) PRIMARY KEY (part_id, parent_part_id),
  INTERLEAVE IN PARENT Part ON DELETE CASCADE;

-- 역방향 탐색용 인덱스 (도착 노드에 인터리브)
CREATE INDEX OrderedByProduct ON CustomerOrderedProduct (product_id)
  STORING (amount_usd), INTERLEAVE IN Product;

-- 테이블을 그래프로 매핑 (데이터 복제 없음)
CREATE PROPERTY GRAPH SupplyChainGraph
  NODE TABLES (Region, Company, Factory, Part, Product, Customer, RiskEvent)
  EDGE TABLES (
    PartComponentOfPart
      SOURCE KEY (part_id) REFERENCES Part (part_id)
      DESTINATION KEY (parent_part_id) REFERENCES Part (part_id)
      LABEL COMPONENT_OF
);데이터 변경은 GQL 그래프 DML이 아니라 SQL 테이블 DML이나 Mutation API로 하며, 커밋된 변경은 다음 그래프 쿼리에 바로 반영됩니다.
노드 테이블과 엣지 테이블 하나씩에 label과 JSON 속성을 두는 스키마리스 모델(DYNAMIC LABEL, DYNAMIC PROPERTIES)도 2025년 9월에 GA가 되었습니다.
대량 데이터는 BigQuery에서 가공한 뒤 EXPORT DATA로 Spanner에 upsert하는 역방향 ETL을 쓸 수 있습니다.
검색 기능은 벡터 검색(KNN은 COSINE_DISTANCE 등, ANN은 APPROX_* 함수와 ScaNN 트리 기반 벡터 인덱스)과 전문 검색(TOKENIZE_FULLTEXT, SEARCH, SCORE)을 그래프 쿼리 안에서 직접 씁니다.
ANN top-k를 찾고 NEXT로 그래프를 확장하는 것이 GraphRAG의 기본 패턴입니다.
그래프 알고리즘(PageRank, 연결 요소, 유사도, 최단 경로 등)은 2026년 5월 기준 Preview로, Data Boost 자원에서 돌아 운영 워크로드에 영향이 거의 없지만 무료 체험판에서는 쓸 수 없습니다.
BigQuery Graph: 분석 엔진 위의 그래프
BigQuery Graph는 BigQuery의 분산 분석 엔진 위에서 대규모 그래프 분석을 하는 서비스로, 2026년 4월 Preview를 거쳐 2026년 8월 31일에 GA가 되었습니다.
Spanner Graph와 같은 스키마와 질의 언어를 쓰며, 그래프는 데이터를 옮기거나 복제하지 않는 논리 뷰입니다.
테이블과 뷰뿐 아니라 외부 테이블, Iceberg, 다른 클라우드 카탈로그, Spanner 연합 쿼리까지 그래프로 엮을 수 있습니다.
과금 조건을 먼저 확인해야 합니다.
GQL 실행에는 Enterprise 이상 예약(reservation)이 필수이며 slot 시간으로 과금합니다.
온디맨드에서는 그래프 생성, GRAPH_EXPAND, 측정값(measures)만 가능하고, 온디맨드에서 GQL을 실행하면 “BigQuery Graph queries require a reservation with Enterprise or Enterprise Plus edition” 오류가 납니다.
스키마 문법은 Spanner와 같지만 네 가지가 다릅니다.
- 그래프와 테이블 이름은 데이터세트로 한정합니다.
- PRIMARY KEY와 FOREIGN KEY는 NOT ENFORCED입니다. 스캔을 줄이는 최적화 정보로 쓰이지만 검증하지 않아, 키가 중복되면 잘못된 결과가 나옵니다.
- INTERLEAVE나 보조 인덱스 같은 그래프 저장 최적화가 없습니다. 클러스터링은 일반 BigQuery 기능입니다.
- 스키마 변경은 CREATE OR REPLACE로 다시 정의하며, 원본 테이블 삭제를 막지 않습니다.
-- 엣지 테이블: 키는 NOT ENFORCED, 출발 키로 클러스터링
CREATE TABLE graph_kg_lab.PartComponentOfPart (
  part_id STRING NOT NULL,
  parent_part_id STRING NOT NULL,
  quantity INT64,
  PRIMARY KEY (part_id, parent_part_id) NOT ENFORCED,
  FOREIGN KEY (part_id) REFERENCES graph_kg_lab.Part(part_id) NOT ENFORCED,
  FOREIGN KEY (parent_part_id) REFERENCES graph_kg_lab.Part(part_id) NOT ENFORCED
) CLUSTER BY part_id;

-- 그래프 정의: Spanner와 같은 문법, 이름만 데이터세트로 한정
CREATE OR REPLACE PROPERTY GRAPH graph_kg_lab.SupplyChainGraph
  NODE TABLES (graph_kg_lab.Region, graph_kg_lab.Company, graph_kg_lab.Factory,
               graph_kg_lab.Part, graph_kg_lab.Product, graph_kg_lab.Customer,
               graph_kg_lab.RiskEvent)
  EDGE TABLES (
    graph_kg_lab.PartComponentOfPart
      SOURCE KEY (part_id) REFERENCES Part (part_id)
      DESTINATION KEY (parent_part_id) REFERENCES Part (part_id)
      LABEL COMPONENT_OF
);BigQuery에만 있는 기능은 측정값(Measures)입니다.
학과 예산을 과목과 조인한 뒤 SUM을 하면 과목 수만큼 예산이 중복 합산되는데, 속성에 MEASURE(SUM(budget))을 정의하고 GRAPH_EXPAND로 평탄화한 테이블에서 AGG()로 읽으면 정의된 노드의 키 기준으로 한 번만 집계됩니다.
GQL 안에서는 measure를 참조할 수 없고, GRAPH_EXPAND는 LEFT JOIN 연쇄라 단일 루트, 비순환, 진입 차수 1 이하인 그래프만 받습니다.
그래프 검색과 시각화는 아직 Preview이며, 검색은 AI.SEARCH나 VECTOR_SEARCH로 후보 ID를 변수에 담은 뒤 GQL에서 WHERE id IN UNNEST(변수)로 필터하는 두 단계 방식으로 문서화되어 있습니다.
같은 문법, 다른 엔진: 성능이 갈리는 이유
문법이 같아 쿼리는 그대로 옮길 수 있지만, 같은 그래프 선언이 Spanner에서는 행 기반 OLTP 엔진으로, BigQuery에서는 컬럼 기반 분석 엔진으로 실행됩니다.
| 항목 | Spanner Graph | BigQuery Graph |
| 엔진 | 행 기반 분산 트랜잭션 DB(스플릿 단위 분산) | 컬럼 기반 분산 분석 엔진(slot 병렬 처리) |
| 저장 | 엣지를 출발 노드에 인터리브, FK, 보조 인덱스 | 일반 컬럼 테이블, 그래프 전용 구조 없음 |
| 실행 | 인덱스 키로 짚어 가는 조인(apply join) 중심 | 스테이지 단위 스캔과 셔플 조인 중심 |
| 비용 | 노드 시간(24시간 상시 과금) | 쿼리가 쓴 slot 시간(Enterprise 예약) |
| 지연 | 밀리초에서 초(공식 비교표) | 초에서 시간(공식 비교표) |
Spanner는 노드와 그 엣지를 물리적으로 붙여 저장해 “이웃 찾기”를 짧은 범위 읽기로 끝냅니다.
BigQuery는 컬럼별로 저장하며 그래프 전용 인접 구조가 문서화되어 있지 않아, 시작 노드가 하나여도 엣지 테이블의 해당 컬럼을 읽어야 합니다.
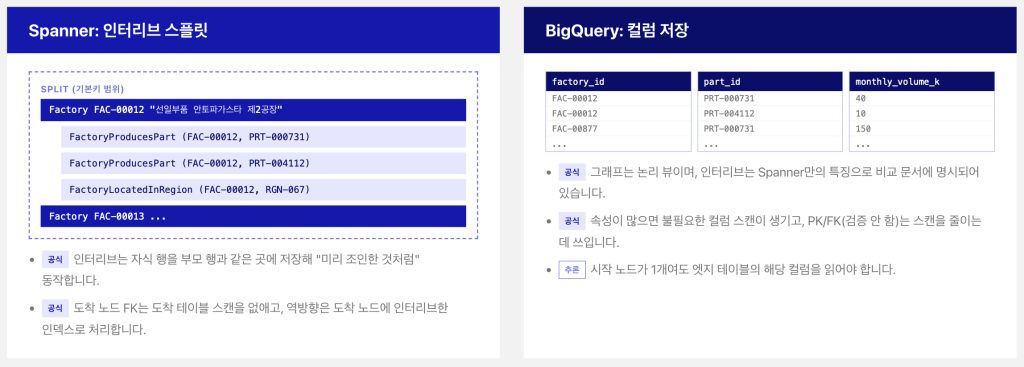
두 엔진 모두 그래프 탐색을 조인으로 실행하지만, Spanner는 키로 짚어 가고 BigQuery는 크게 읽어 맞춰 봅니다.
Spanner의 기본 조인 연산자는 Apply join으로, 입력 행이 적고 조인 키가 상대 기본키의 앞부분이며 인터리브된 테이블일 때 가장 효율적입니다.
가변 길이 경로는 Recursive union 연산자가 한 홉씩 반복 실행하고, JOIN_METHOD나 FORCE_INDEX 같은 힌트로 실행 방식을 지정할 수 있습니다.
BigQuery의 그래프 쿼리는 SQL 쿼리처럼 스테이지 그래프로 바뀌어 slot에서 병렬로 돌고 셔플로 데이터를 주고받으며, 범위 수량자는 상한을 반드시 지정해야 합니다.
그래서 Spanner의 비용은 쿼리가 실제로 건드리는 이웃의 수를 따라가고, BigQuery의 비용은 스캔하고 셔플하는 데이터의 양과 slot 수를 따라갑니다.
같은 쿼리라도 튜닝 포인트가 다르므로 공식 권장사항을 항목별로 맞대어 보는 것을 권장드립니다.
| 요소 | Spanner Graph | BigQuery Graph |
| 탐색 시작점 | 키나 인덱스로 찾은 적은 수의 노드에서 시작할 때 가장 빠름 | 카디널리티가 낮은 노드에서 시작해 중간 결과를 작게 유지 |
| 저장 배치 | INTERLEAVE 여부가 핵심 | 그래프 전용 배치 없음. 속성 목록을 좁혀 컬럼 스캔 축소 |
| 역방향 탐색 | 도착 키 인덱스를 도착 노드에 인터리브 | 방향을 지정한 탐색 권장(무방향은 성능 저하 가능) |
| 가변 길이 경로 | 상한 없는 경로는 ANY, TRAIL 등과 함께만 허용(깊이 최대 100) | 상한 필수. 고정 길이 패턴의 합집합으로 해석 |
| 슈퍼 노드 | IS_FIRST 샘플링, factorized 실행 힌트 | ROW_NUMBER로 엣지 샘플링 |
| 확장 방식 | 노드 수에 비례해 QPS가 선형 확장 | 예약 slot 수만큼 병렬 처리(autoscale 상한) |
| 과금 단위 | 노드 시간, 쿼리 수와 무관하게 상시 과금 | slot 시간, 쿼리가 돌 때만 과금(50 slot 단위, 최소 1분) |
| 데이터 신선도 | 커밋 즉시 반영, 강한 일관성 | 쿼리 시점의 테이블 기준(근실시간 또는 배치) |
세부 기능에도 차이가 있습니다.
Spanner에만 있는 것은 상한 없는 수량자, 쿼리 힌트, 스키마리스 모델, 내장 그래프 알고리즘(Preview)이고, BigQuery에만 있는 것은 측정값입니다.
요소 키는 Spanner가 기본키를 항상 검증하는 반면 BigQuery는 NOT ENFORCED라 중복을 검증하지 않습니다.
같은 데이터, 같은 GQL로 실측해 보기
공식 문서의 포지셔닝이 실제로 맞는지 같은 데이터와 같은 질문으로 확인하는 과정을 소개합니다.
서울 리전(asia-northeast3)에 Spanner 무료 체험판 인스턴스와 BigQuery Enterprise 예약(기본 0 slot, 자동 확장 최대 50 slot)을 두고, 모든 리소스에 라벨을 붙여 실습 리소스만 정확히 롤백할 수 있게 구성합니다.
예약은 프로젝트에 할당하지 않고 쿼리 작업마다 지정하면 다른 사용자의 쿼리에 영향을 주지 않습니다.
이 구성에서 실제로 든 비용은 gemini-embedding-001로 문서 64,009건을 임베딩한 약 2달러뿐입니다.
데이터는 가상의 전자제품 제조사의 글로벌 공급망입니다.
답이 여러 단계 떨어져 있는 공급망은 의미 검색과 그래프의 차이가 가장 분명하게 드러나는 분야입니다.
| 구성 | 내용 |
| 노드 7종, 64,078개 | 회사 4,800, 공장 9,509, 부품 28,000, 제품 1,200, 고객사 20,000, 지역 69, 사건 500 |
| 엣지 9종, 331,642개 | 주문 180,585, BOM 75,004, 생산 49,110, 지분 2,440 등 |
| 자연어 문서 64,009건 | 그래프의 모든 사실을 개체당 문서 1건으로 빠짐없이 문장화 |
| 임베딩 | gemini-embedding-001, 768차원, 문서와 질문에 같은 모델 |
| 구조적 특징 | 1. 원자재부터 완제품까지 다단계 BOM 2. 가상 제재 리스트 기업 아래 최대 6단계 지분 사슬 |
그래프의 모든 사실을 문서에도 똑같이 담았기 때문에, 두 방식은 같은 지식에서 찾는 방법만 다릅니다.
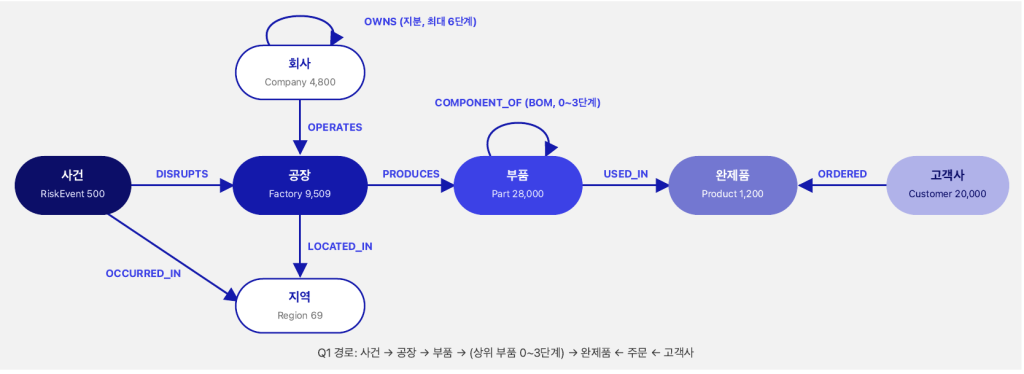
검증 질문은 의미 검색의 한계 유형마다 하나씩 데이터에서 자동으로 고릅니다.
| No | 질문 | 그래프 패턴 | 정답 |
| Q1 | 특정 공장의 출하 중지로 영향받는 고객사와 주문 금액은? | 6홉과 집계 | 고객사 1,268곳, 8억 5,167만 달러 |
| Q2 | 제재 기업이 직접 또는 간접 지배하는 회사는? | 가변 길이 1~6단계 | 회사 20곳 |
| Q3 | 특정 지역 수출 규제로 대체 공급이 불가능한 부품은? | NOT EXISTS | 부품 24개 |
| Q4 | 배터리 셀 BC-6606이 들어가는 완제품은? | 정확 식별과 3홉 | 제품 3개 |
| Q5 | 단일 소싱 부품 중 공급 중단 시 매출 영향이 가장 큰 5개는? | 전체 그래프 집계 | 부품 5개 |
비교 방법은 네 단계입니다.
CSV를 파이썬 그래프로 읽어 BFS로 정답 집합을 직접 계산하고, 의미 검색은 질문 임베딩과 코사인 거리가 가까운 문서 top-10과 top-50(정확 KNN)을 가져오고, 그래프 검색은 같은 GQL을 Spanner와 BigQuery에서 실행한 뒤, 정밀도와 재현율, 지연 시간 중앙값(워밍업 후 3회)을 측정합니다.
의미 검색에는 최대한 유리하게, 상위 문서에 정답 개체 이름이 한 번이라도 등장하면 찾은 것으로 인정합니다.
BigQuery는 캐시를 끄고 Enterprise 예약에서 실행합니다.
정확도: 관계 질문은 그래프
그래프 쿼리는 5개 질문 모두 두 DB에서 정답과 정확히 일치합니다.
의미 검색은 관대한 채점에서도 대부분 놓칩니다.
| No | 의미 검색 top-10 정밀도 / 재현율 | 의미 검색 top-50 정밀도 / 재현율 | 그래프 결과(Spanner, BigQuery) |
| Q1 | 0% / 0% | 8.9% / 0.3% | 일치 |
| Q2 | 9.4% / 15% | 2.3% / 15% | 일치 |
| Q3 | 35.9% / 79.2% | 20.3% / 100% | 일치 |
| Q4 | 0% / 0% | 0% / 0% | 일치 |
| Q5 | 0% / 0% | 0% / 0% | 일치 |
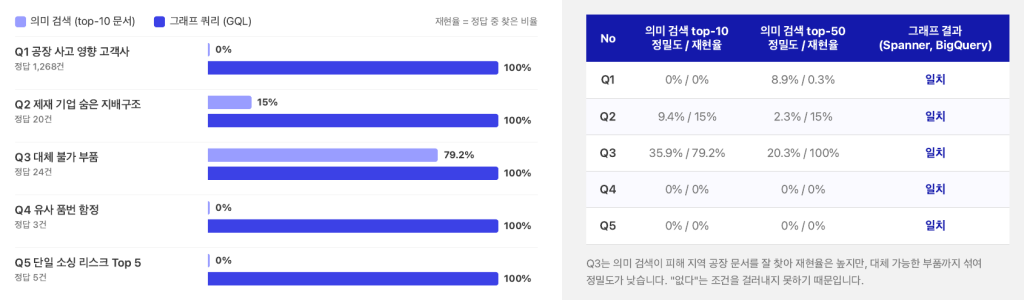
Q3는 의미 검색이 피해 지역 공장 문서를 잘 찾아 재현율은 높지만, 대체 가능한 부품까지 섞여 정밀도가 낮습니다.
“없다”는 조건을 걸러내지 못하기 때문입니다.
Q1에서는 의미 검색이 사고 뉴스와 그 공장 문서를 정확히 찾지만 거기서 멈춥니다.
고객사는 6홉 떨어져 있어 질문과 문장이 비슷하지 않고, 찾은 문서에는 영향받는 고객사 이름이 하나도 없습니다.
같은 질문을 그래프 쿼리로 쓰면 영향 완제품 9개, 고객사 1,268곳, 영향 주문 금액 851,666,822달러를 한 번에 계산하고, 파이썬으로 계산한 정답과 정확히 일치합니다.
MATCH (e:RiskEvent {event_id: @event_id})
  -[:DISRUPTS]->(:Factory)-[:PRODUCES]->(:Part)
  -[:COMPONENT_OF]->{0,3}(:Part)-[:USED_IN]->(:Product)
  <-[o:ORDERED]-(c:Customer)
RETURN c.customer_id, o.order_id, o.amount_usd응답 시간: 강점이 정반대
같은 GQL이라도 엔진에 따라 강점이 정반대입니다.
한 지점에서 출발하는 탐색은 Spanner가, 그래프 전체를 훑는 집계(Q5)는 BigQuery가 압도적으로 빠르며, 공식 비교표의 포지셔닝과 일치합니다.
| 측정 항목 | Spanner Graph | BigQuery Graph |
| Q1 공장 사고 영향 고객사 | 47ms | 1.9초 |
| Q2 제재 기업 숨은 지배구조 | 16ms | 2.1초 |
| Q3 대체 불가 부품 | 125ms | 584ms |
| Q4 유사 품번 함정 | 68ms | 1.7초 |
| Q5 단일 소싱 리스크 Top 5 | 5분 58초(첫 실행 기록) | 1.6초 |
| Q6 GraphRAG 하이브리드 | 146ms | 1.8초 |
| 의미 검색 KNN top-10 | 207ms | 1.7초 |
| 의미 검색 ANN top-10 | 58ms | 인덱스 미생성 |
| Q1, Q5 slot 사용 | 해당 없음 | 21.6 slot초, 34.5 slot초 |
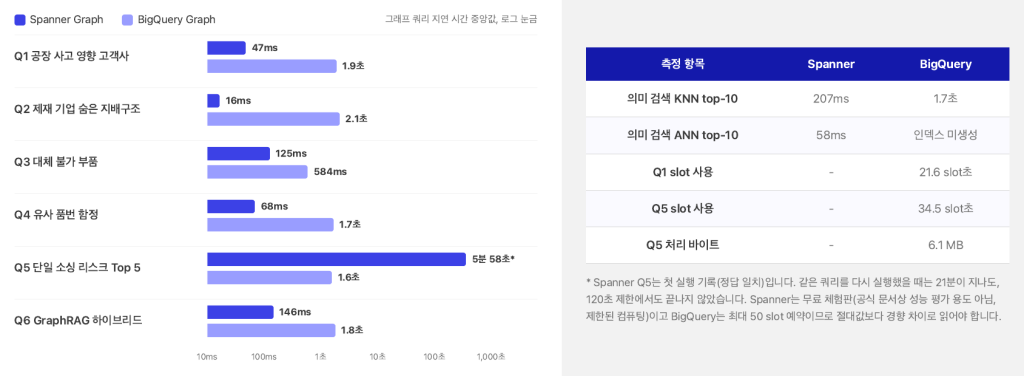
Spanner의 Q5는 첫 실행 기록이며, 같은 쿼리를 다시 실행하면 21분이 지나도, 120초 제한에서도 끝나지 않습니다.
실행 계획을 보면 Q1은 키 범위 조회로 이웃만 읽지만, Q5는 부품 전체를 스캔한 뒤 행마다 경로를 확장합니다.
공식 문서도 이런 작업은 BigQuery나 Data Boost 기반 알고리즘을 안내합니다.
Spanner는 무료 체험판(성능 평가 용도 아님, 제한된 컴퓨팅)이고 BigQuery는 최대 50 slot 예약이므로, 절대값보다 경향 차이로 읽어야 합니다.
GraphRAG: 벡터로 시작점을 찾고 그래프로 넓히기
의미 검색과 그래프는 경쟁이 아니라 역할 분담입니다.
“최근 미국 콜럼버스에 있는 협력사 공장에서 품질 문제로 출하 중지가 생겼다는데, 그 때문에 공급에 영향받는 완제품은?” 같은 자연어 질문은 사건 이름을 모르는 상태에서 시작합니다.
RiskEvent 노드의 뉴스 임베딩과 질문의 코사인 거리로 가장 가까운 사건 1건을 고른 뒤, NEXT로 그 사건에서 공장, 부품, 상위 부품을 거쳐 완제품까지 확장하는 쿼리를 GQL 한 문장으로 씁니다.
GRAPH SupplyChainGraph
-- 1단계: 의미가 가장 가까운 사건 찾기 (벡터)
MATCH (e:RiskEvent)
WHERE e.scope = '공장'
RETURN e, COSINE_DISTANCE(e.embedding, @query_embedding) AS distance
ORDER BY distance
LIMIT 1
NEXT
-- 2단계: 그 사건에서 그래프로 영향 범위 확장
MATCH (e)-[:DISRUPTS]->(:Factory)-[:PRODUCES]->(:Part)
  -[:COMPONENT_OF]->{0,3}(:Part)-[:USED_IN]->(prod:Product)
RETURN DISTINCT e.event_id, e.title, prod.product_id, prod.name두 DB 모두 정답 사건을 찾고 영향 제품 재현율 100%를 기록하며, 지연은 Spanner 146ms, BigQuery 1.8초입니다.
BigQuery에서는 그래프 이름만 graph_kg_lab.SupplyChainGraph로 바꿔 실행합니다.
BigQuery 문서는 검색과 GQL을 두 단계로 나누는 방식만 안내하지만, 실측에서는 GQL 안에서 COSINE_DISTANCE로 정렬한 뒤 NEXT로 확장하는 한 문장 하이브리드 쿼리도 동작합니다.
이식성도 확인됩니다.
그래프 쿼리 6개 모두 이름 한정만 바꿔 두 DB에서 같은 결과를 내고, EXISTS 서브쿼리에서 바깥 변수를 다시 선언한 부분 하나만 BigQuery에서 오류가 나 고치면 됩니다.
둘 중 하나가 아니라 함께 쓰는 구조
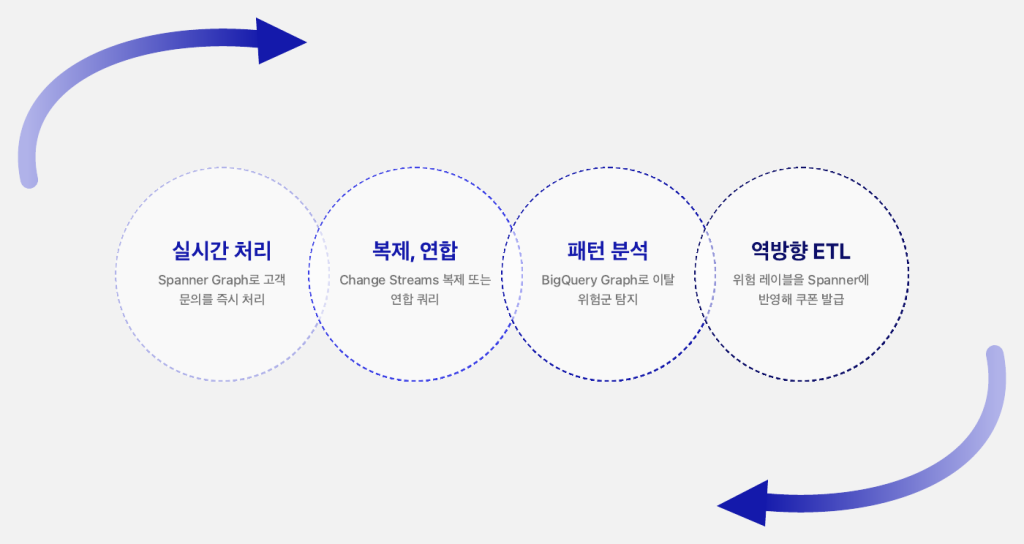
공식 문서는 둘 중 하나를 고르기보다 함께 쓰는 순환 구조를 제시합니다.
고객 360 예시에서는 Spanner Graph가 고객 문의를 즉시 처리하고, Change Streams 복제나 연합 쿼리로 BigQuery에 데이터를 넘기고, BigQuery Graph가 이탈 위험군을 탐지한 뒤, 역방향 ETL로 위험 레이블을 Spanner에 반영해 쿠폰을 발급합니다.
같은 스키마와 GQL을 공유하므로 두 서비스 사이에서 쿼리를 옮기는 비용이 거의 없습니다.
선택 가이드
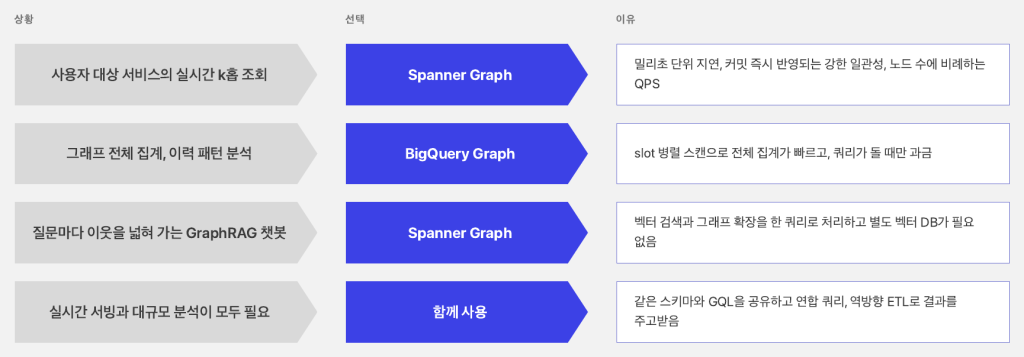
질문이 “특정 지점에서 출발해 이웃을 빠르게 찾는가”, 아니면 “그래프 전체를 훑어 집계하는가”를 먼저 보면 선택이 쉬워집니다.
| 상황 | 선택 | 이유 |
| 사용자 대상 서비스의 실시간 k홉 조회 | Spanner Graph | 밀리초 단위 지연, 커밋 즉시 반영되는 강한 일관성, 노드 수에 비례하는 QPS |
| 그래프 전체 집계, 이력 패턴 분석 | BigQuery Graph | slot 병렬 스캔으로 전체 집계가 빠르고, 쿼리가 돌 때만 과금 |
| 질문마다 이웃을 넓혀 가는 GraphRAG 챗봇 | Spanner Graph | 벡터 검색과 그래프 확장을 한 쿼리로 처리하고 별도 벡터 DB가 필요 없음 |
| 실시간 서빙과 대규모 분석이 모두 필요 | 함께 사용 | 같은 스키마와 GQL을 공유하고 연합 쿼리, 역방향 ETL로 결과를 주고받음 |
이 비교에서 확인되는 장점
- 1. 같은 스키마와 GQL이라 쿼리를 그대로 옮길 수 있습니다.
그래프 쿼리 6개가 이름 한정만 바꿔 두 DB에서 같은 결과를 냅니다. - 2. 국소 탐색은 Spanner Graph가 밀리초로 답합니다.
한 지점에서 출발하는 Q1부터 Q4까지 Spanner는 16ms에서 125ms, BigQuery는 584ms에서 2.1초입니다. - 3. 전체 집계는 BigQuery Graph가 압도적입니다.
2.8만 개 부품 전체를 훑는 Q5가 BigQuery에서는 1.6초, Spanner에서는 5분 58초입니다. - 4. 벡터 검색과 그래프 확장을 한 쿼리로 묶는 GraphRAG가 가능합니다.
사건 이름을 모르는 자연어 질문에서 출발해 영향 완제품을 재현율 100%로 찾습니다.
주의할 점
- 1. Spanner 무료 체험판 수치는 경향으로만 읽어야 합니다.
공식 문서가 성능 평가 용도가 아니라고 명시하며, 1노드 미만 인스턴스는 비선형 성능을 보일 수 있습니다. - 2. BigQuery Graph의 GQL 실행에는 Enterprise 이상 예약이 필수입니다.
온디맨드에서는 그래프 생성, GRAPH_EXPAND, 측정값만 가능하므로 예약과 slot 비용을 먼저 계획해야 합니다. - 3. BigQuery Graph는 키 제약을 검증하지 않습니다.
PRIMARY KEY와 FOREIGN KEY가 NOT ENFORCED라, 원본 테이블의 키 중복을 적재 단계에서 직접 막아야 합니다. - 4. 세부 기능 차이를 설계 전에 확인해야 합니다.
수량자 상한, 쿼리 힌트, 스키마리스 모델, 측정값, 그래프 알고리즘 Preview 여부가 서비스마다 다릅니다.
마무리
질문이 “특정 지점에서 출발해 이웃을 빠르게 찾는가”인지 “그래프 전체를 훑어 집계하는가”인지를 먼저 보면, Spanner Graph와 BigQuery Graph 중 무엇을 선택할지가 분명해집니다.
실시간 GraphRAG와 서비스는 Spanner Graph, 대규모 패턴 분석은 BigQuery Graph에 맡기고 같은 스키마로 데이터를 주고받는 구성을 권장드립니다.
무료 체험판 인스턴스와 기본 0 slot 예약으로 비용 없이 검증부터 시작해 보시는 것을 권장드립니다.
궁금한 점이 있으신가요?
자세한 문의는 GS Neotek 홈페이지를 이용해 주세요.


최신 댓글