Snowflake Cortex AI, 데이터 옆에서 바로 쓰는 AI
안녕하세요. GS Neotek 조승기 입니다.
지난 글(Snowflake 도입, GS Neotek과 함께)에서는 왜 Snowflake인지를 이야기했습니다.
이번 글에서는 그중 요즘 가장 많이 질문받는 Snowflake Cortex AI를 소개하겠습니다.
생성형 AI를 데이터 분석에 쓰고 싶다는 고객은 많습니다.
그런데 막상 시작하려면 “회사 데이터를 외부 AI 서비스로 보내도 되나”, “권한은 어떻게 지키나”, “AI용 인프라를 따로 만들어야 하나” 같은 질문에서 멈춥니다.
Cortex AI는 이 질문들에 대한 Snowflake의 답입니다.
Cortex AI란
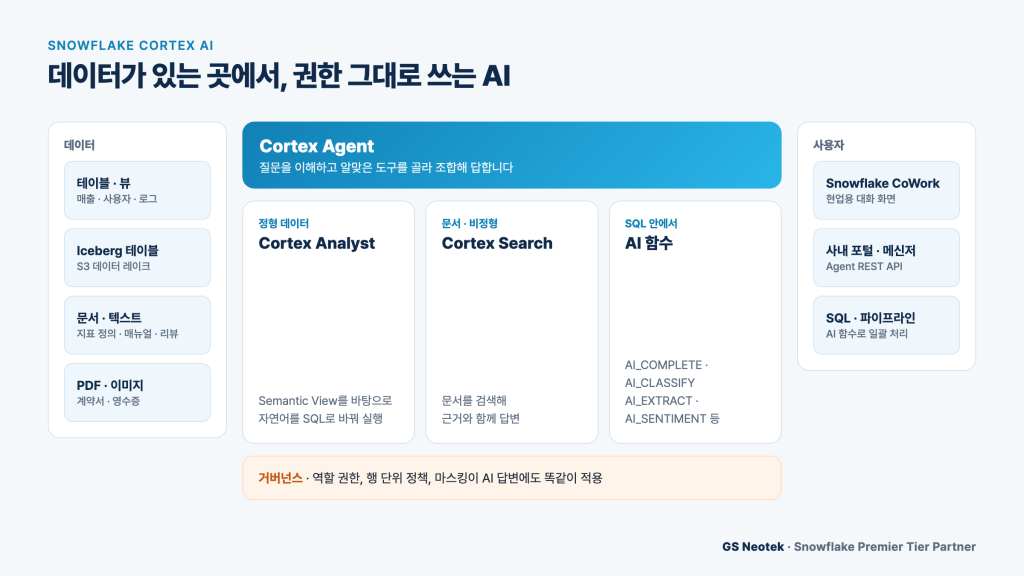
Cortex AI는 Snowflake 안에 들어 있는 생성형 AI 기능 묶음입니다.
데이터를 AI가 있는 곳으로 옮기는 대신, AI를 데이터가 있는 곳으로 가져옵니다.
- AI 함수
AI_COMPLETE, AI_CLASSIFY, AI_EXTRACT, AI_SENTIMENT 같은 함수를 SQL 안에서 바로 씁니다.
텍스트 분류, 요약, 정보 추출, 번역, 문서 파싱을 쿼리 한 줄로 처리합니다. - Cortex Analyst
자연어 질문을 SQL로 바꿔 실행합니다.
지표 정의와 계산 규칙을 담은 Semantic View를 바탕으로 답하기 때문에, 회사마다 다른 지표 기준을 따릅니다. - Cortex Search
문서와 텍스트를 검색해 근거와 함께 답합니다.
지표 정의서, 업무 매뉴얼, 고객 리뷰처럼 표로 담기 어려운 지식을 다룹니다. - Cortex Agent
질문을 이해하고 위 도구들을 골라 조합해 답합니다.
“지난달 매출이 왜 떨어졌어?”처럼 수치와 맥락이 함께 필요한 질문을 한 번에 처리합니다. - Snowflake CoWork
현업 사용자가 에이전트와 대화하는 화면입니다(이전 이름 Snowflake Intelligence).
사내 포털이나 메신저에 붙이고 싶다면 Agent REST API로 연결합니다.
왜 Cortex AI인가
- 1. 데이터를 외부 AI 서비스로 보내지 않습니다.
AI 처리가 Snowflake 안에서 이뤄지므로, 데이터를 별도 AI 서비스로 내보내는 파이프라인이 필요 없습니다.
다른 리전의 모델을 쓰도록 설정한 경우에도 질문과 답변이 처리되는 동안만 전송되고, 데이터는 계정 리전에만 저장됩니다. - 2. 지금 쓰는 권한이 AI 답변에도 그대로 적용됩니다.
역할 권한, 행 단위 정책, 마스킹을 AI용으로 다시 만들 필요가 없습니다.
볼 수 없는 데이터는 AI에게 물어봐도 보이지 않습니다. - 3. AI 인프라를 따로 만들지 않습니다.
GPU, 벡터 DB, 모델 서버를 구성하고 운영할 필요가 없습니다.
쓴 만큼 크레딧으로 과금됩니다. - 4. 모델을 골라 씁니다.
Claude, Gemini 등 여러 최신 모델을 함수 인자 하나로 바꿔 씁니다.
작업 난이도와 비용에 맞춰 모델을 고를 수 있습니다. - 5. 데이터 팀이 직접 운영합니다.
Semantic View는 YAML, 에이전트 규칙은 텍스트, 문서는 Markdown으로 관리합니다.
코드 배포 없이 정의와 규칙을 고치는 것만으로 AI의 답이 바뀝니다.
이렇게 씁니다
SQL 안에서 바로 – AI 함수
아래는 저희 파트너 계정에서 예시 고객 리뷰 세 건에 AI 함수를 적용한 실제 결과입니다.
분류, 감성 분석, 상담원 답변 초안까지 SQL 한 번으로 나왔습니다.
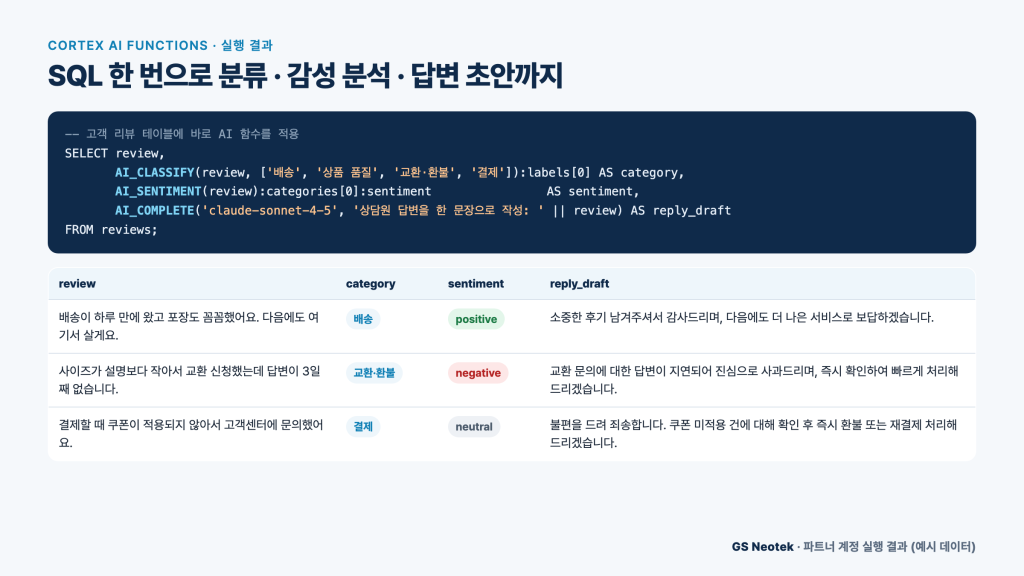
같은 쿼리를 수백만 건의 리뷰·상담 기록·VOC 테이블에 그대로 돌릴 수 있습니다.
다만 마지막 행의 답변 초안처럼 AI가 사실과 다른 약속(“즉시 환불”)을 쓰기도 하므로, 고객에게 나가는 문장은 사람이 확인하는 단계를 두는 것이 좋습니다.
자연어로 묻고 답하기 – 분석 에이전트
현업 사용자는 SQL을 몰라도 됩니다.
이번 글을 위해 파트너 계정에 가상의 온라인 쇼핑몰 주문 데이터(약 2만 건)와 Semantic View, 에이전트를 만들어 “10월 할인 행사 기간에 주문이 얼마나 늘었어?”라고 물어봤습니다.
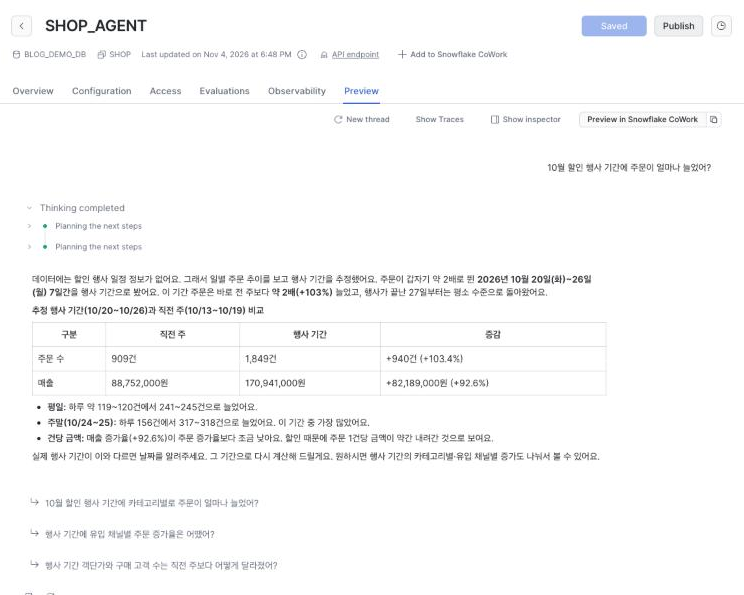
눈여겨볼 부분은 첫 문장입니다.
데이터에는 행사 일정이 없었는데, 에이전트는 이를 숨기지 않고 “주문이 갑자기 2배로 뛴 기간을 행사로 추정했다”고 근거를 밝혔습니다.
그다음 직전 주와 비교한 표를 만들고, 실제 행사 기간이 다르면 알려 달라고 되물었습니다.
답이 어떻게 나왔는지도 그대로 확인할 수 있습니다.
아래는 같은 질문의 처리 과정(Traces)입니다.
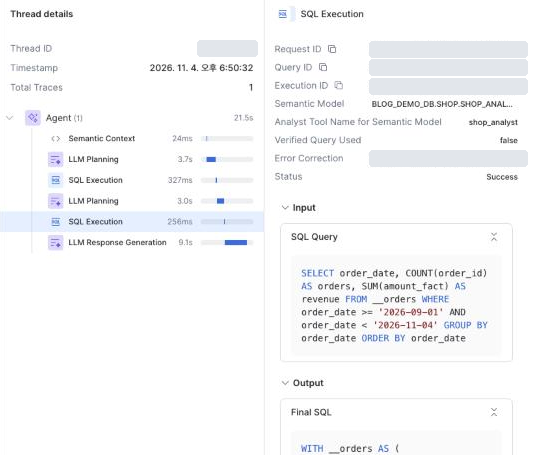
에이전트는 Semantic View를 읽고, 계획을 세우고, SQL을 실행한 뒤 답변을 만들었습니다.
첫 번째 SQL은 컬럼 이름을 잘못 써서 오류가 났는데, 에이전트가 이를 스스로 고쳐 다시 실행했습니다(Error Correction).
어떤 SQL을 실행했는지가 모두 남기 때문에, 숫자를 믿고 써도 되는지 데이터 팀이 바로 검증할 수 있습니다.
구축은 이렇게 합니다
에이전트를 만드는 것 자체는 어렵지 않습니다.
어려운 것은 현업이 믿고 쓸 만큼 정확하게 만드는 것입니다.
저희는 아래 순서로 구축하고, 평가와 개선을 반복합니다.
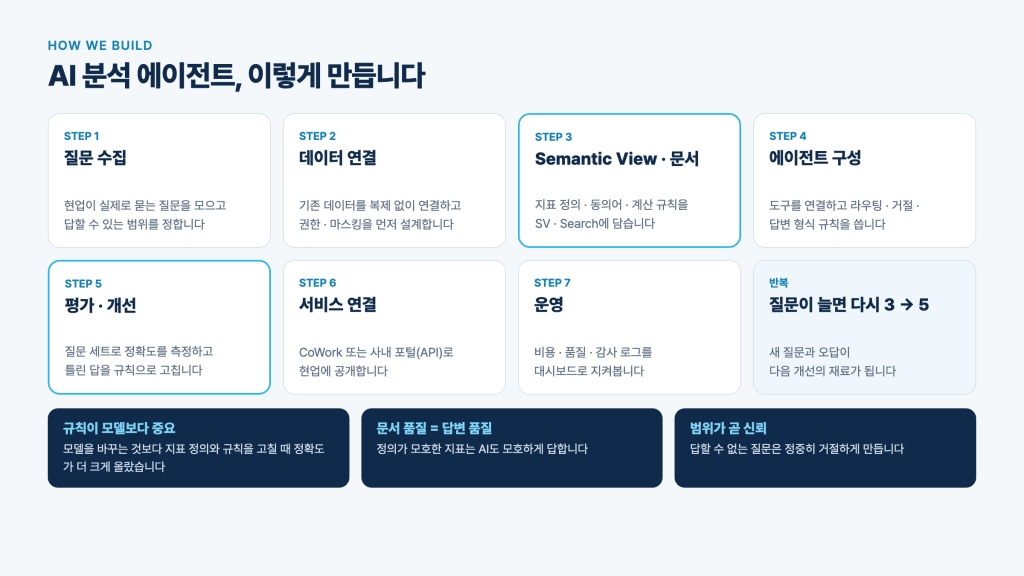
여러 프로젝트를 거치며 확인한 것은 세 가지입니다.
- 1. 규칙이 모델보다 중요합니다.
정답률이 낮을 때 모델을 바꾸는 것보다, 지표 정의와 계산 규칙을 바로잡을 때 효과가 더 컸습니다.
“이 지표는 날짜끼리 더하면 안 된다” 같은 규칙 하나가 오답 여러 개를 없앴습니다. - 2. 문서 품질이 곧 답변 품질입니다.
사람끼리도 정의가 엇갈리는 지표는 AI도 엇갈리게 답합니다.
그래서 구축의 상당 부분은 지표 정의를 정리하고 문서로 남기는 일입니다. - 3. 답하지 말아야 할 질문을 정하는 것이 신뢰를 만듭니다.
없는 데이터를 그럴듯하게 지어내는 것이 가장 위험합니다.
범위 밖 질문과 권한 밖 질문은 정중히 거절하도록 규칙을 두고, 평가 질문으로 따로 검증합니다.
비용은 이렇게 봅니다
Cortex AI는 쓴 만큼 크레딧으로 과금됩니다.
비용은 크게 아래로 나뉩니다.
| 구분 | 무엇에 비용이 드나 |
| AI 함수 | 처리한 입력·출력 토큰 수 (모델마다 단가가 다름) |
| Cortex Analyst · Agent | 질문 처리와 도구 호출에 쓰인 토큰 |
| Cortex Search | 문서 임베딩과 검색 서비스 유지 |
| 웨어하우스 | 에이전트가 만든 SQL을 실행하는 시간 |
같은 질문이라도 모델, 도구 수, 실행되는 SQL에 따라 비용이 달라집니다.
저희가 진행한 프로젝트에서는 에이전트 질문 한 번에 대략 0.15~0.2 크레딧 수준이었지만, 구성에 따라 차이가 큽니다.
그래서 PoC 단계에서 실제 질문으로 사용량을 측정해 운영 비용을 함께 제시합니다.
운영 중에는 에이전트별 예산과 사용자별 사용 한도를 걸어 비용이 예상 밖으로 늘지 않게 관리할 수 있습니다.
Cortex AI, GS Neotek과 함께하면
- 1. 첫 질문부터 현업 기준으로 맞춥니다.
현업이 실제로 묻는 질문을 먼저 모아, 무엇을 답하고 무엇을 거절할지 정한 뒤 시작합니다.
같은 질문 세트로 정확도를 측정하기 때문에 “얼마나 맞는지”를 숫자로 보고받습니다. - 2. 회사의 지표를 AI가 이해하는 형태로 옮깁니다.
흩어진 지표 정의와 업무 문서를 Semantic View와 검색용 문서로 정리합니다.
이 정리 자체가 회사의 데이터 자산으로 남습니다. - 3. 보안 검토를 통과하는 구조로 만듭니다.
권한·마스킹 설계, 감사 로그, 거절 규칙과 프롬프트 공격 테스트까지 공개 전에 점검합니다. - 4. 현업이 쓰는 자리까지 연결하고, 데이터 팀에 넘깁니다.
CoWork나 사내 포털로 공개하고, 비용·품질 대시보드로 운영합니다.
데이터 팀이 직접 규칙을 고칠 수 있도록 핸즈온 교육과 운영 가이드를 함께 드립니다.
마치며
Cortex AI는 데이터를 옮기지 않고, 권한을 다시 만들지 않고, 별도 인프라 없이 생성형 AI를 쓰게 해 줍니다.
남은 과제는 AI가 회사의 지표를 정확히 이해하고, 현업이 그 답을 믿고 쓰게 만드는 일입니다.
GS Neotek은 Snowflake AI Data Cloud Services Premier Tier 파트너로서 질문 정의부터 운영까지 함께하겠습니다.
궁금한 점이 있으신가요?
자세한 문의는 GS Neotek 홈페이지를 이용해 주세요.

최신 댓글